
AIに記事を勝手に学習されるのは防ぎたいが、AI検索からの流入が減るのは困るとお悩みの経営者は多いはずです。
本記事ではrobots.txtとllms.txtを使い分け、無断学習の防止とAI検索流入を両立させる具体的な実務指針を解説します。
なぜ2026年の企業サイトに「AIクローラー対策」が不可欠なのか?
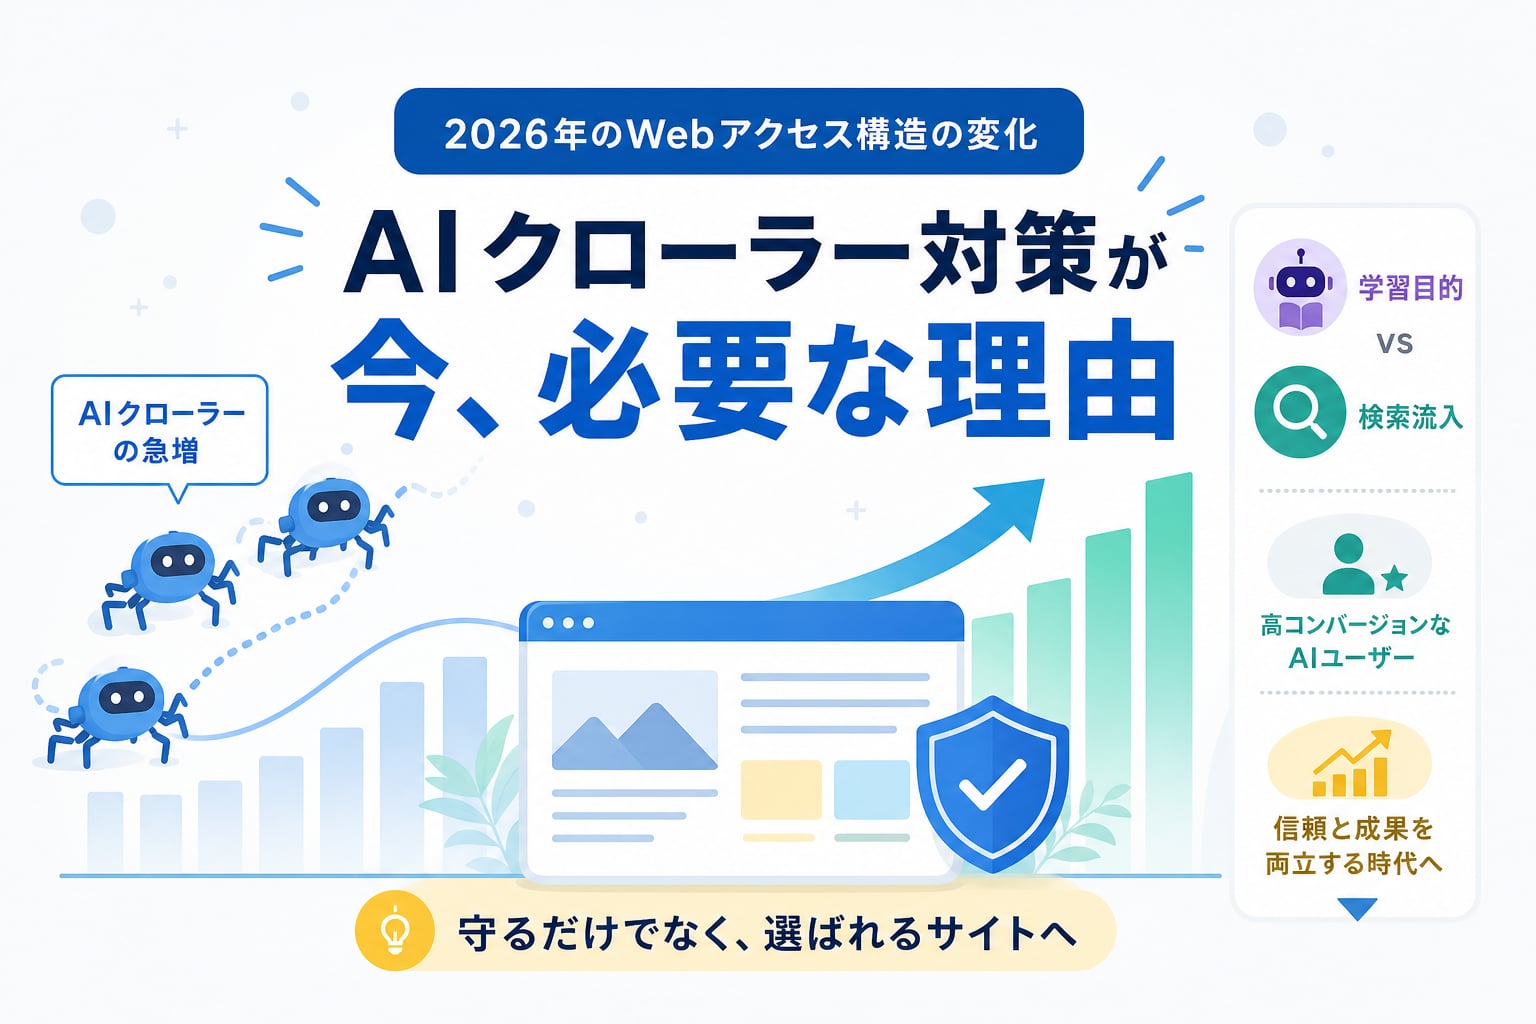
2026年現在、Webサイトへのアクセス構造は劇的に変化しています。
かつてはGooglebotなどの検索エンジンが主役でしたが、現在はChatGPT(OpenAI)、Claude(Anthropic)、PerplexityなどのAIクローラーが急増しています。
AIクローラーには学習目的のものが含まれ、自社の独自ノウハウがAIの回答に流用される可能性が懸念されています。
一方で、AI検索エンジンからの流入は無視できない価値を持ち始めています。
AI検索経由の訪問者は、検討が進んだ状態でサイトを訪れている可能性があります。
BtoB企業や高額商材を扱うビジネスにおいて、AIクローラーをすべて拒否することは、成約意欲の高い見込み客をみすみす逃すことと同義といえます。
さらに、AIクローラーには「モデルの学習用」と「検索回答の生成用」の2種類が存在することに注意が必要です。
これらを混同して一括でブロックしてしまうと、著作権は守れても、AI検索(AI OverviewやAI検索サービス等)の結果に自社サイトが引用されなくなります。
AI検索が広がる今、企業には「守り」と「攻め」を両立したクローラー制御が求められています。
AI経由の流入が全体の一部にとどまるBtoBサイトでも、1件の問い合わせが大きな商談につながる可能性があるのがBtoBの特性です。
参考: AI検索の根拠に選ばれるデータ戦略、Overview of OpenAI Crawlers
robots.txtとllms.txtの違いとは?AI検索における役割を比較
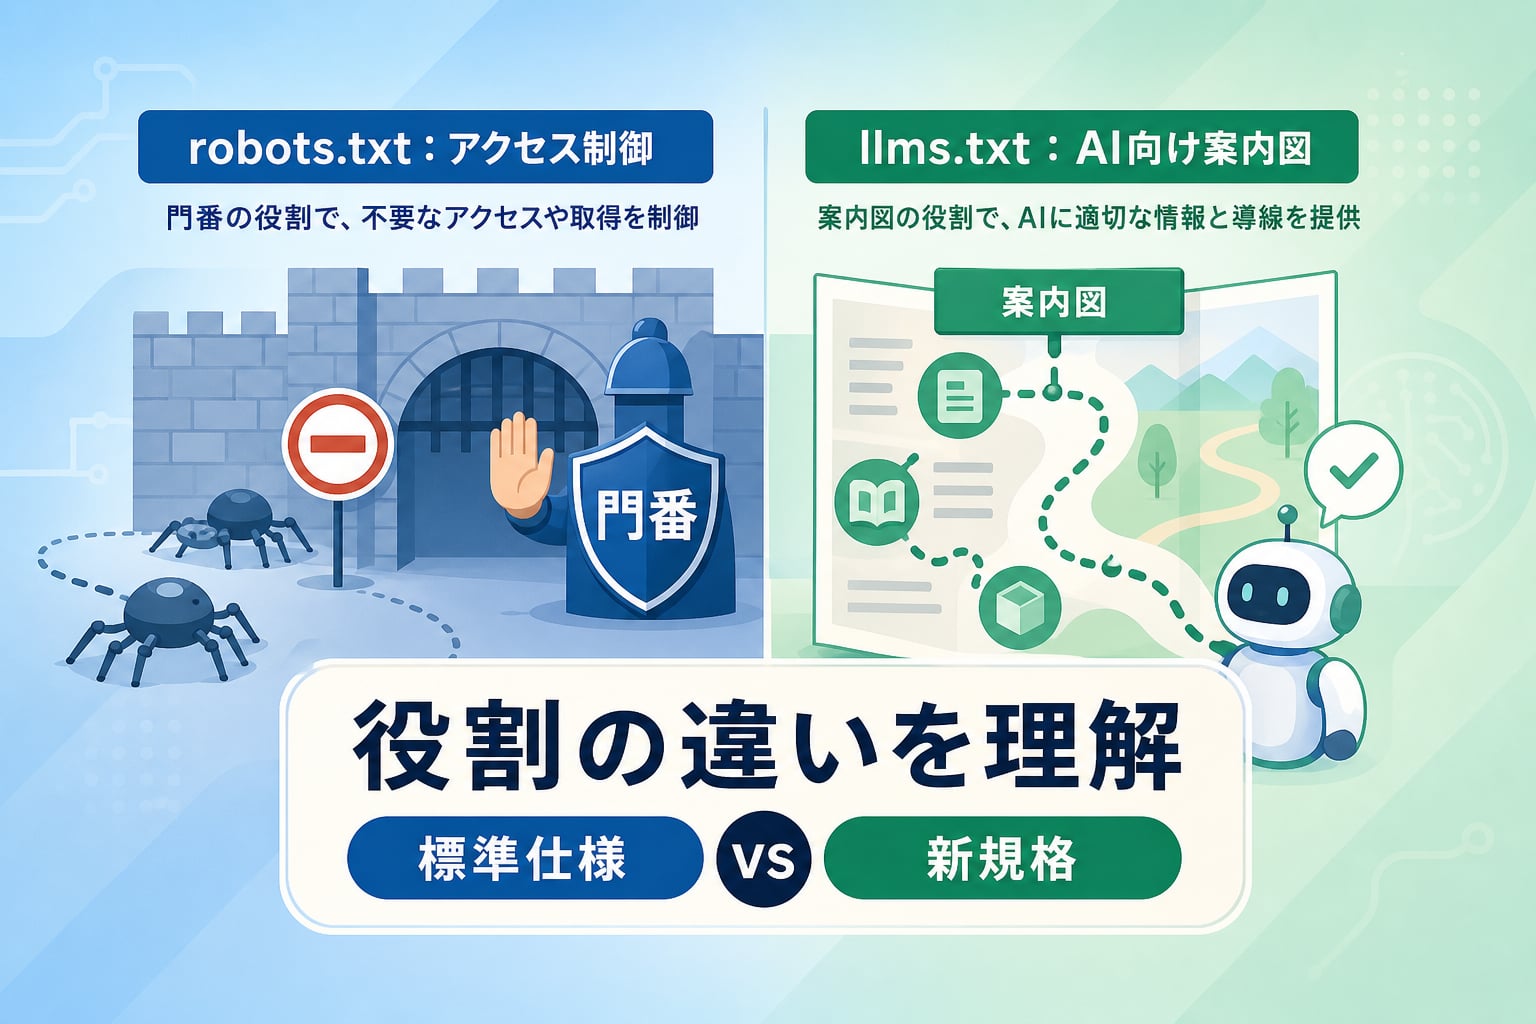
AIクローラー対策の基本となるのが、robots.txtとllms.txtの2つのファイルです。
robots.txtはWebサーバーのルートディレクトリに設置するテキストファイルで、クローラーに対して「どのページへのアクセスを許可・拒否するか」を指示する門番の役割を果たします。
これは長年使われてきた標準的な仕様(RFC 9309)であり、主要なAI企業もこの指示を尊重すると公表しています。
対してllms.txtは、2024年に提案された比較的新しい規格で、AIにサイトの内容を効率的に伝えるための「案内図」のような役割を持ちます。
Markdown形式で記述し、AIに優先的に読んでほしいページや、サイトの概要を簡潔に示します。
Anthropicなどは自社サイトで採用していますが、Googleは公式ドキュメントで、AI機能に掲載されるためにllms.txtなどのAI向け専用ファイルは不要と説明しており、対応状況には温度差があります。
これら2つのファイルは、一方が他方を代替するものではなく、組み合わせて使うことが有効です。
robots.txtで「物理的なアクセスの可否」を制御し、許可したクローラーに対してllms.txtで「情報の優先順位」を提示するという役割分担になります。
この使い分けを正しく行うことで、サーバー負荷を抑えつつ、AI検索エンジンに正確な情報をインデックスさせることが可能になります。
| 項目 | robots.txt | llms.txt |
|---|---|---|
| 主な役割 | クローラーのアクセス制御(拒否・許可) | AI向けの内容ガイド(優先ページの提示) |
| 記述形式 | プレーンテキスト(Disallow/Allow) | Markdown形式(# 見出し、- リンク) |
| 標準化の状況 | 国際標準(RFC 9309)として確立 | コミュニティ提案の慣行(標準化途上) |
| Googleの対応 | 完全対応(クロール制御に必須) | AI機能向けの専用ファイルは不要と説明 |
| 主な対象 | すべての検索・AIクローラー | LLM・AIエージェント |
参考: llms.txtの活用と実装、RFC 9309: Robots Exclusion Protocol
無断学習の防止とAI検索からの流入を両立させるための具体的な判断基準は?
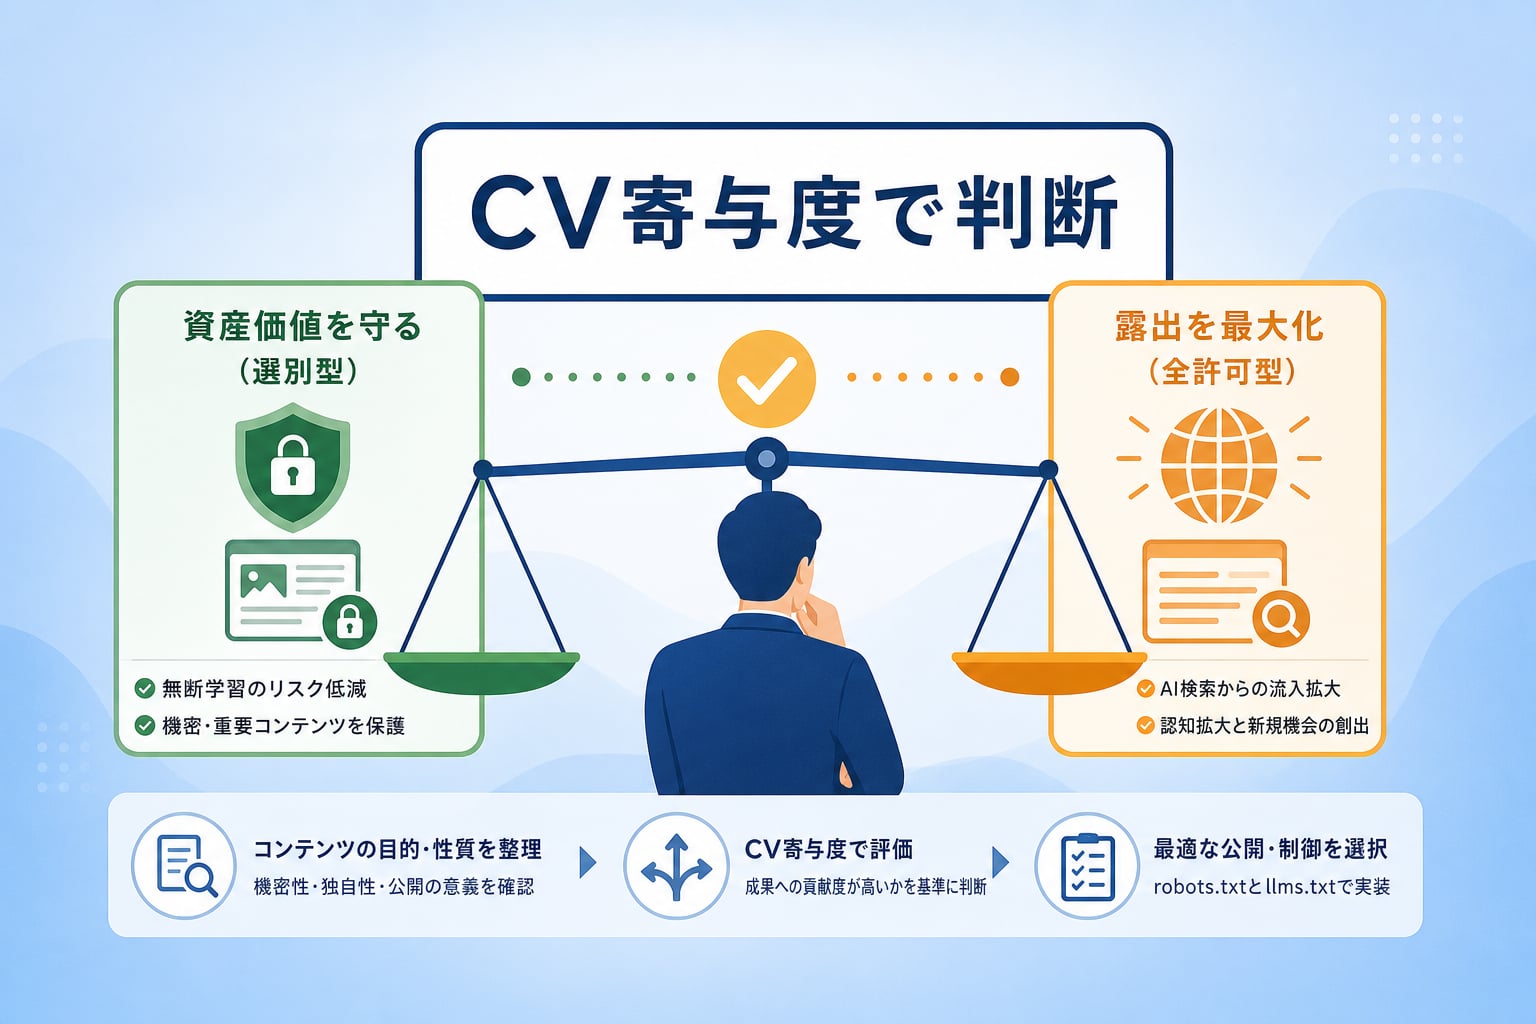
AIクローラーへの対応方針を決める際、最も重要なのは「コンテンツの資産価値」と「流入によるビジネス機会」の天秤です。例えば、独自の調査データや有料級のノウハウを掲載しているメディアの場合、学習用クローラー(GPTBotなど)をブロックして権利を守る「選別型」の対策が推奨されます。
一方で、認知拡大が最優先のコーポレートサイトであれば、すべてのクローラーを許可して露出を最大化する選択肢もあります。
判断の基準として、AI経由の流入が「実際にコンバージョンに寄与しているか」を確認すべきです。
自社サイトでもGA4などでリファラを確認し、ChatGPTやPerplexityからの流入がある程度見込めるのであれば、検索用クローラー(PerplexityBot等)は原則として許可すべきです。
多くのBtoB企業にとっての現実解は、用途ごとに扱いを分けることです。
OpenAIやAnthropicは、学習用と検索回答用で異なるユーザーエージェント(UA)名を名乗っています。
これらを個別にrobots.txtで指定することで、「AIの学習には使わせないが、ユーザーの質問に対する回答の引用元としては表示させる」という高度な制御が可能になります。
これが、2026年における賢明なリスク管理といえるでしょう。
| 戦略 | メリット | デメリット | 向いているサイト |
|---|---|---|---|
| 全面許可 | AI検索での露出を最大化できる | コンテンツが学習に無断利用される | 一般的な会社HP、広報メディア |
| 選別型(推奨) | 権利保護と流入確保を両立できる | robots.txtの記述が複雑になる | BtoBサイト、専門情報サイト |
| 全面拒否 | 独自の知的財産を保護しやすい | AI検索からの流入がゼロになる | 有料会員サイト、独自DB、教材 |
参考: AIO対策の投資対効果の判断基準
【実践】AIクローラーを目的別に制御するrobots.txtの書き方
具体的な実装では、User-agentごとにDisallow(拒否)とAllow(許可)を記述します。
例えば、OpenAIの学習用ボットである「GPTBot」は拒否し、ChatGPTの検索結果向けボットである「OAI-SearchBot」は許可するという設定が可能です。
ただし、robots.txtはクローラー側が尊重する前提の取り決めであり、完璧な遮断を保証するものではない点は理解しておく必要があります。
また、主要なAIクローラーの名称を正確に把握しておくことも重要です。
OpenAIならGPTBot、AnthropicならClaudeBot、PerplexityならPerplexityBotなどが代表的です。
これらをrobots.txtの先頭に記述し、その後にDisallowの指示を続けます。
Meta系やApple系のボットなど他のAIボットも存在するため、定期的にサーバーログを確認し、未知のボットが過剰なアクセスをしていないか監視する運用が求められます。
主要AIクローラーのUser-agent設定例
2026年の標準的な設定例として、学習用ボットをブロックしつつ、検索用を許可する記述を紹介します。
例えば、OpenAIの学習用は「User-agent: GPTBot」に対して「Disallow: /」を指定します。
一方で、Perplexityからの流入を維持したい場合は「User-agent: PerplexityBot」に対して「Allow: /」を明記します。
このように個別に指定することで、意図しない学習を防ぎつつ、AI検索経由のリード獲得経路を守ることができます。
- 現状のアクセスログを確認する: サーバーログやCDNのレポートから、どのAIボットがどの程度の頻度で来訪しているかを把握します。
- ボットごとの許可・拒否方針を決める: 自社のコンテンツ資産を守るべきか、AI検索からの流入を優先すべきかをボットごとに判断すると考えられます。
- robots.txtを編集・アップロードする: User-agentとDisallow/Allowを正しく記述し、サイトのルート直下に配置します。
- 反映確認と定期的なログ監視を行う: 公開後に記述ミスがないか確認し、月次でボットの挙動とAI経由の流入数をチェックすると考えられます。
参考: AI検索対策の自動化運用
llms.txtを導入してAIエージェントに「正しく」情報を伝える手順
llms.txtを導入する最大の目的は、AIに対して「このサイトの重要ページはこれだ」と能動的に提示することにあります。
AIクローラーはサイト内の全ページを等しく理解するわけではありません。
llms.txtに会社概要、サービス詳細、導入事例、FAQなどの主要URLを絞って掲載することで、AIが回答を生成する際の情報の精度を高められる可能性があります。
これは、BtoBサイトにおける情報の「誤読」を防ぐために有効な手段です。
記述はMarkdown形式で行い、AIに優先して読んでほしい情報を簡潔にまとめます。
H1タグにサイト名、その後に短いサイトの説明を書き、リスト形式で重要ページのタイトルとURLを並べます。
例えば、導入事例のページには「導入事例をまとめたページ」といった短い説明文を添えると、AIエージェントがそのリンクの文脈を理解しやすくなります。
- 重要URLの棚卸し: サービスページや会社情報、代表的な記事、FAQなど、AIに優先して読んでほしいURLを抽出すると考えられます。
- Markdownでの構成作成: 見出し、短い説明、URLの順で整理します。AIにも人間にも読みやすい自然な文章を心がけます。
- サイトルート直下への配置: https://example.com/llms.txt として公開し、ブラウザから正常にアクセスできるか確認します。
- robots.txtとの整合性確認: llms.txtで紹介しているページが、robots.txtで誤ってブロックされていないか最終チェックを行います。
専門知識なしでAI検索とSEOの両方に最適化した記事運用を自動化するには?
ここまで解説したrobots.txtやllms.txtの設定は、あくまで「AIに情報を読ませるための土台」に過ぎません。
実際にAI検索(AI OverviewやChatGPT等)で自社が引用されるためには、AIが理解しやすく、かつユーザーの課題を解決する高品質なコンテンツを継続的に発信し続ける必要があります。
しかし、多くの経営者やマーケティング責任者にとって、日々の業務の中でAIとSEOの両方に最適化した記事を書き続けるのは至難の業です。
そこで有効なのが、当社の提供する「AutoAIO」です。
キーワードを入力するだけで、検索エンジンとAI検索の両方に最適化された記事を自動生成し、WordPressへの自動投稿まで完結できます。
外注に比べて低いコストで、ベーシックプラン(月額19,800円・税抜)なら月30記事の運用が可能です。
AutoAIOの最大の特徴は、公開後の効果測定とリライト提案までAIが行う点です。
単に記事を作って終わりではなく、Google Search Consoleのデータを元に「どの記事をどう直すべきか」をAIが提案し、承認するだけで改善のループが回ります。
物価も人件費も上がり続ける今、AIが得意な「大量のデータ処理と執筆」はAIに任せ、人間は「戦略の決定と承認」に集中すべきです。
AutoAIOなら初期費用0円で、30日間の無料体験も用意されています。
無料体験では最大30本の記事案を生成して、その品質をお試しいただけます。
AIクローラー対策という「守り」を固めつつ、AutoAIOでAI検索流入という「攻め」を加速させ、Web集客を次のステージへ進めましょう。
| 比較項目 | SEO外注・ライター | AutoAIO |
|---|---|---|
| 月間コスト | 外注の内容により異なる | 19,800円〜(税抜) |
| 1記事単価 | 外注の内容により異なる | 約660円(月30本の場合) |
| 投稿・入稿作業 | 手動(数時間〜数日) | WordPressへ自動投稿 |
| 改善(リライト) | 別途費用・期間が発生 | AIが自動提案・承認のみ |
| AI検索(AIO)対策 | 担当者の知見に依存 | 標準機能として最適化済み |
よくある質問
Q1. そもそも「AIクローラー」とは何ですか?
AIクローラーとは、AIモデルの学習や最新情報の取得のために、インターネット上の情報を自動で収集して回るプログラムのことです。
従来の検索エンジンとは異なり、回答の生成に情報を利用するのが特徴です。
Q2. robots.txtとllms.txtは、具体的にどう使い分ければいいですか?
robots.txtは「クローラーの立ち入り禁止」を命令する際に使い、llms.txtは「AIが理解しやすい要約情報の提供」に活用します。
拒否したい場合は前者、活用してほしい場合は後者を優先しましょう。
Q3. 無断学習は拒否したいですが、AI検索結果には表示させたい場合はどうすればいいですか?
学習用のクローラーのみをrobots.txtでブロックし、回答生成用のクローラーは許可する設定にします。
併せてllms.txtを設置して正確な情報を伝えることで、学習を防ぎつつ検索流入を狙えます。
Q4. 設定を間違えると、これまでのGoogle検索順位に悪影響はありますか?
AIクローラー向けの記述と、Google検索用のGooglebot向けの記述は別々に指定できます。
Googlebotを誤ってブロックしない限り、従来のSEOへの影響は出にくくなります。
Q5. これらを一度設定すれば、将来的にずっと安心でしょうか?
新しいAIサービスやクローラーが次々と登場するため、一度の設定で完璧ではありません。
定期的に最新のクローラー名をリストに追加したり、新しい技術仕様に合わせて設定を更新したりする継続的な管理が必要です。